千问办公上了10款模型,我花一晚上试了三件活
看到千问办公11月16号一口气上了10款模型的消息,我第一反应是:选项多了,反而不知道该怎么选了。新旗舰Qwen4-Max首发,DeepSeek、Kimi、GLM这些也都接了进来,个人版和企业标准版都能在输入框旁边自己挑。
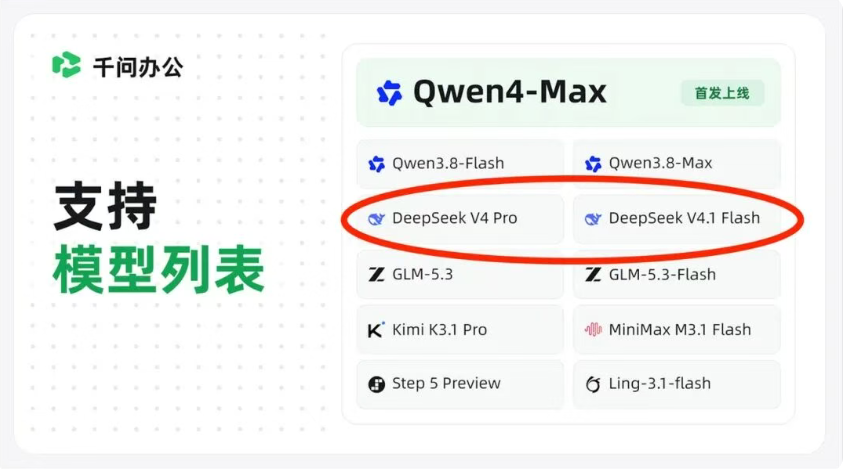
以前用千问办公,模型那一栏基本不用看,反正只有它自己的模型。现在价格写得明明白白,问题就来了:这么多模型,到底哪个干哪种活划算?
我没急着下结论。花了一晚上,拿手里三件真实的工作挨个跑了一遍。
下载地址:千问PC版官方下载
三道题,只看第一次交付
三道题是这样的。
第一道,从一段群聊里提取待办,做成表格。第二道,写代码,做一个报价计算器,财务和业务都能直接用。第三道,上网查资料,写一份AI算力行业简报。
每道题选三到四个模型来跑。同一句指令原封不动发出去,只看第一次交付,不追问、不补提示、不给第二次机会。每件活事先写好检查点,只判对错,不打印象分。
第一件活:群聊待办,谁又快又准
办公里最高频的活,往往不是写长文。工作群里几十条消息,有人@人、有人催进度、有人答应了没给准信。得把待办一条条捋出来,谁负责、什么时候交,做成一张能直接贴进周报的表。
我挑了一段群聊,七句话,信息量不小。指令是提取成表格,含事项、责任人、截止时间、状态四列,没有明确时间的标待定。
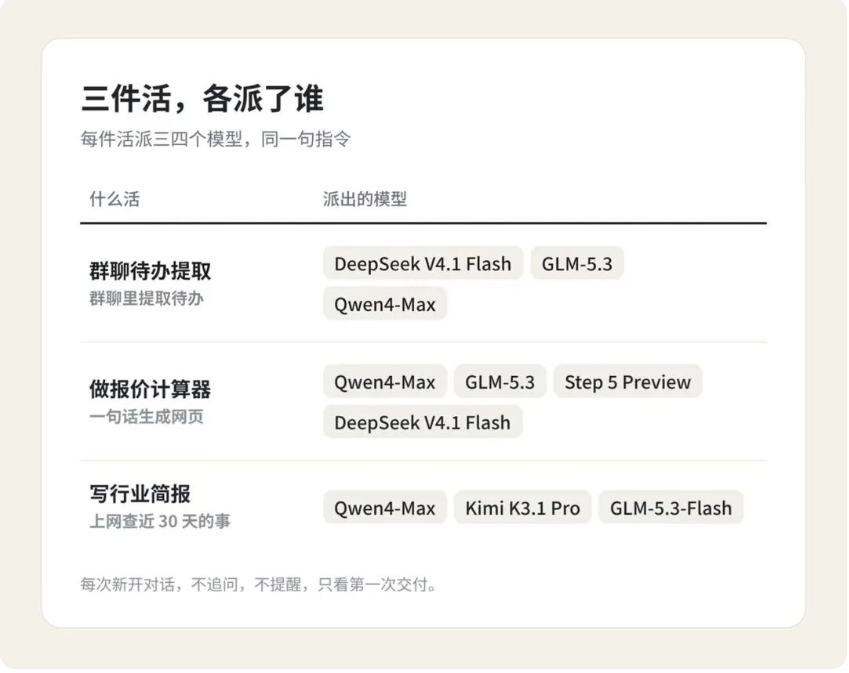
上场的是DeepSeek V4.1 Flash、GLM-5.3和Qwen4-Max。
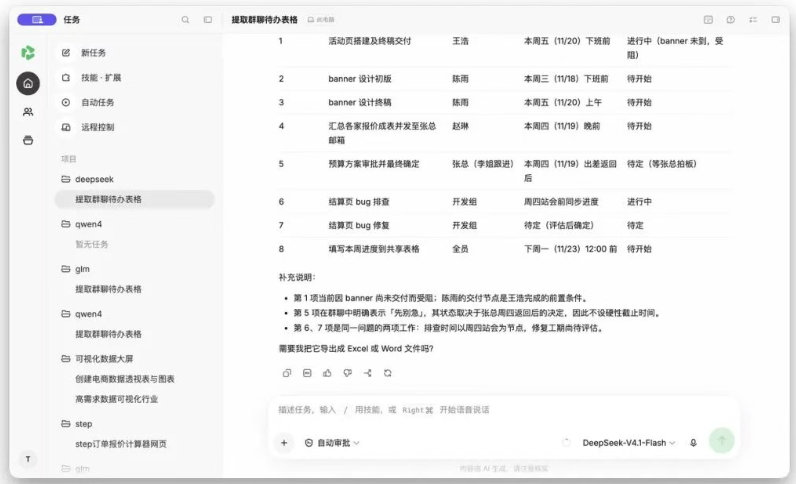
DeepSeek V4.1 Flash 15秒交卷。列了8条待办,把这周五、下周一都换算成了具体日期,责任人一个没搞错,两个没给准信的事项标了待定,没瞎编。末尾还主动补了三条说明,点出陈雨的banner是王浩活动页的前置条件。唯一的小瑕疵是指令要四列,它自己加了个序号列,变成五列。
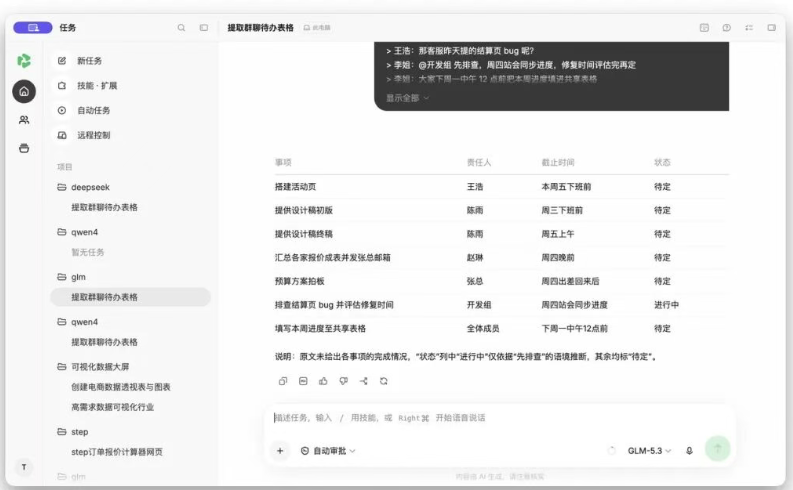
GLM-5.3严格按四列交卷,把bug的排查和修复合成一条,总共7条。责任人全对,进行中只给了有据可查的那一条,其余标待定,还专门写了说明解释为什么这么标。但它的时间停在了“本周五”“周三”这种相对说法,没换算成具体日期,真要拿去排日程还得自己再算一遍。
Qwen4-Max 36秒,一处没错。7条待办,日期换算一个不差。状态列是三个里最讲究的:等拍板的写待拍板,还没排查的写待排查,普通事项写待办,一眼能看出每件事卡在哪。bug修复时间正确标了待定,还附了日期推算说明。
这道题三个模型没有一个出硬伤。输入短、路径单一、答案有标准答案,比的是细心,不是推理。差距只在速度和细节。
我的选法:这种单步抽取的轻量活,直接交给Flash,十多秒交卷、结果拿来就能用。上Max属于能力溢出,它的强项是多步推理,在一道找信息、填表格的题上,多等的时间和多花的钱换不回能感知到的差别。
不是越贵的越好。轻量任务,Flash就够了。需要层层推理的复杂活,再让Max上场。
第二件活:报价计算器,三个坑没人掉
第二件活是做一个报价计算器。规则互相牵扯:买得多有折扣,满额能用券,但两样只能选一样。运费还得看优惠之后的金额。
我备了三组数字,每组底下埋着一个坑。四个模型上场:GLM-5.3、DeepSeek V4.1 Flash、Qwen4-Max和Step 5 Preview。我把数字挨个输进去,等着看谁先掉下去。
全对。
答案一样,交卷的方式不一样。GLM-5.3最快,40秒。DeepSeek V4.1 Flash最省。Qwen4-Max最让人放心,交卷前它自己先跑了11组刁钻数字,比如刚好500元、差1块到300元,确认没问题才给我。Step 5 Preview也是一次做对。
这里有个容易误判的地方:模型旁边标的身价是单价,不是这份活的账单总价。同一个任务,有的模型三两下交卷,有的要自己反复试算、多跑几轮工具。Qwen4-Max那11组自测不会让答案变得更好看,但它把交付前的检查自己先做了一遍。活干得更细,额度自然吃得更多,光看模型名字旁边的单价,很难猜中这份活最后会扣多少。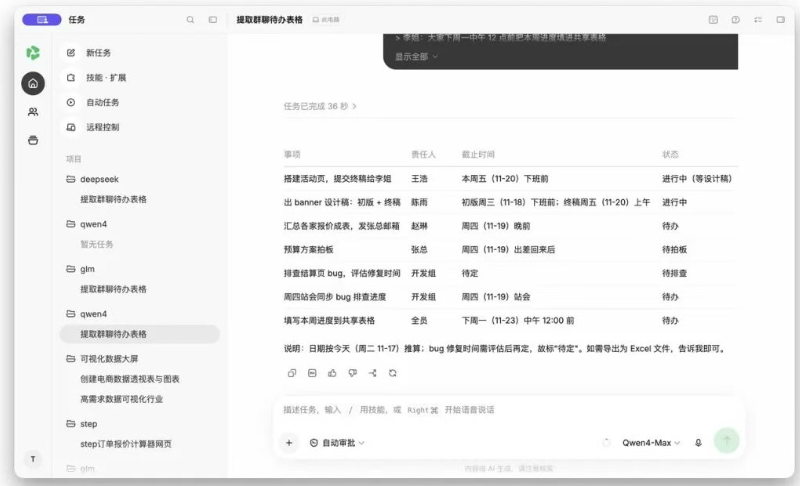
Qwen4-Max的优点,就藏在这种看不见的地方。两道题跑下来,它不是每次都最快,但交出来的东西有个共同点:拿到手基本不用返工。待办提取里,它把状态分成待拍板、待排查、待办三种,一眼能看出每件事卡在哪,还附上了日期是怎么推出来的。计算器这道题,交卷前它先出了11组刁钻数字,把自己考了一遍。
这类活难的不是某一步,而是步骤一多,哪一步漏了结果都会出错。Max的做法是把每一步怎么来的摆出来,再回头自己查一遍。
越是步骤多、要拿出去用的复杂活,越值得多等它那几十秒。
我的选法:规则清楚的小工具,不必挑最贵的。想省,选DeepSeek V4.1 Flash。想稳,选Qwen4-Max。赶时间,选GLM-5.3,40秒拿到,答案一样。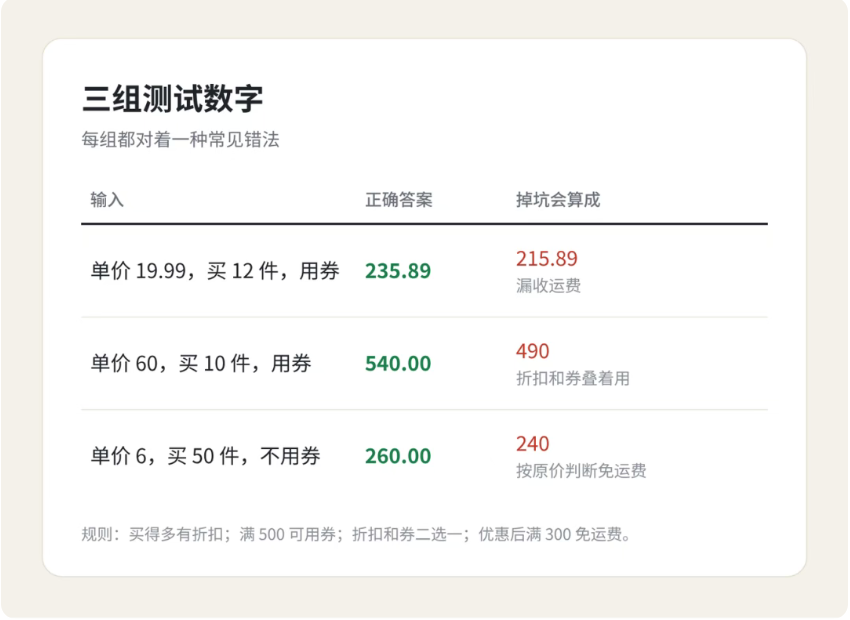
第三件活:查资料,谁更较真
第三件活最容易翻车:上网查资料,写一份AI算力行业简报。只许写最近30天的事,每条都要带链接。这种活最怕两件事:旧闻当新闻,链接点开对不上。
GLM-5.3-Flash 1分14秒,8条。快,还主动给3条拿不准的消息标了未核实。链接都对得上,只是有一条引的是别家的转述,不是一手来源。它图的是快,拿不准的会直说。
Qwen4-Max 1分40秒,链接和日期都对得上。
Kimi K3.1 Pro 5分45秒,只交了6条。别人都交卷了,它还在查。但这6条我逐条核对,链接、日期、数字,没挑出一处错,也没有一条需要标未核实。
这道题我没像看计算器那样给三份结果判同分,因为用途本来就不同。自己想快速扫一眼行情,GLM-5.3-Flash一分钟出头就有,了解个大概足够。要拿去汇报、给别人看,用Kimi K3.1 Pro,它的6条逐条核对无错。Qwen4-Max夹在中间,链接可靠。
三道题跑下来
三道题,唯一每道都上场的是Qwen4-Max。群聊待办,它一处没错。计算器,它一次做对,还自己出题把自己考了一遍。行业简报,链接和日期全对得上。
它不是每道题的单项冠军。论快有Flash,论较真有Kimi。但换一道题、换一种活,它都能稳稳交卷,没有哪道题让它掉链子。而且它总爱多做一步:给状态分类、写清日期怎么推的、交卷前先自测。这些东西不在检查点里,却是别人拿到结果后最省心的部分。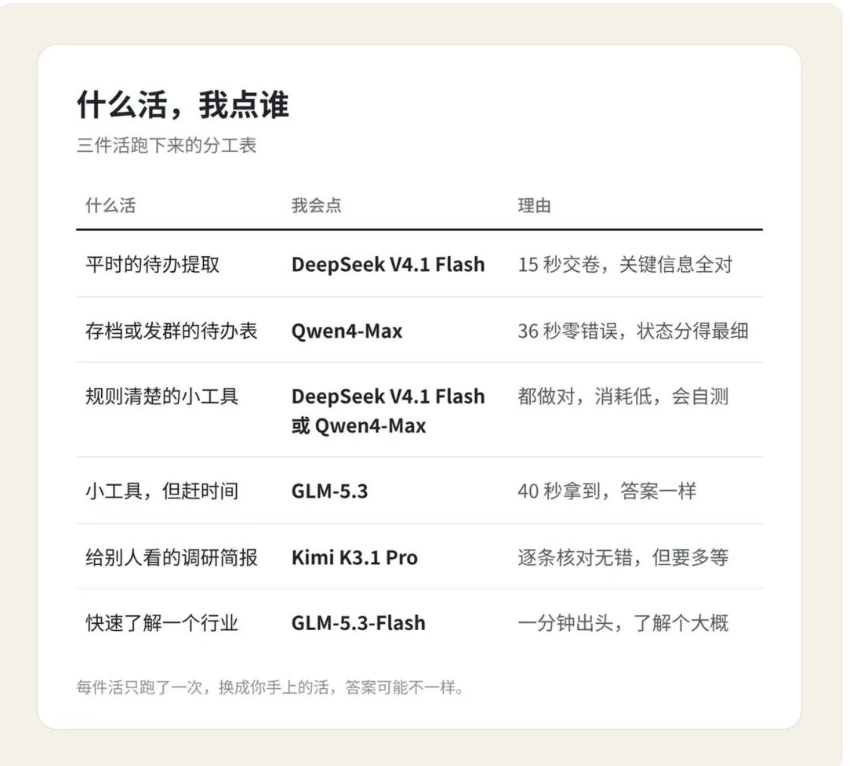
选模型之前最好先想清楚一件事:拿到结果以后,准备用它做什么。
比如待办提取,只是自己看、群里同步,DeepSeek足够。要发老板、要存档,Qwen4-Max的就OK了。到了行业简报,链接是一手还是二手、数字要不要复核,比文末挂了多少条来源重要得多。
这也解释了阿里为什么明明有自己的模型,仍愿意把Kimi、GLM、DeepSeek接进千问办公。假如用户习惯用Kimi做长材料核对,过去遇到写代码、做表格的任务还得切换到别的平台,这部分需求阿里就很难留住。如今Kimi已经出现在千问办公的菜单中,核对完资料,还可以在同一个窗口里接着做网页、改代码,不用再切换平台。
对于企业来说,各部门分别要订阅哪个模型,也是一笔值得思考的账单。市场部偶尔需要Kimi,研发部有几项任务想用DeepSeek。如果分别购买,就要考虑给哪些人开通账号、每个部门购买多少额度。如今多个模型可以共用一套Credits,管理员还能按部门或成员配置谁可以用哪些模型,灵活分配用量。对模型厂商而言,这也增加了接触办公用户的机会。
写在后面
三件活跑完,最直观的感受不是哪个模型最强,而是终于不用一个模型硬扛所有活了。
整理待办要又快又准、代码工具要稳、行业简报要较真,任务不同,合适的模型本来就不同。千问办公这次把Qwen4-Max首发摆上台面,也让Kimi、GLM、DeepSeek、MiniMax、Step等模型同台可选。个人版和企业标准版用户可以在模型列表里按任务自由选择。
这不是简单多加几个选项,而是把Agent从黑盒全家桶往白盒自选推了一步。把选择权交给用户,这才是办公Agent走向成熟的样子。


